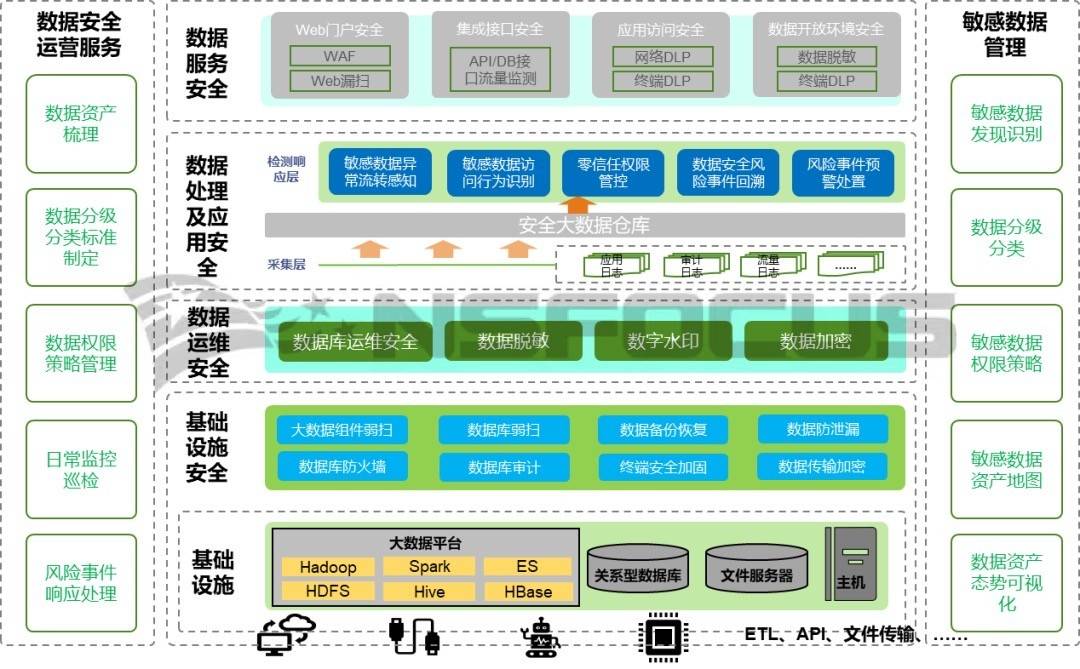
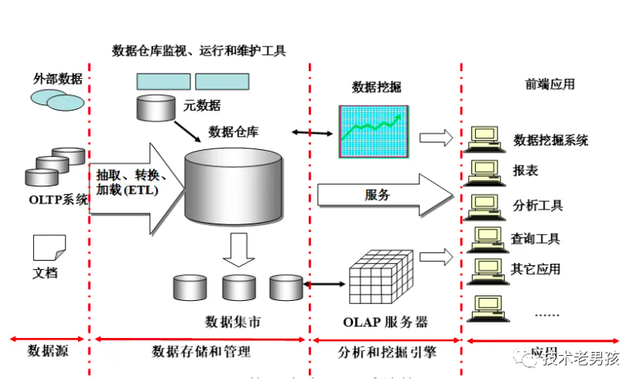
在當今數(shù)據(jù)驅(qū)動的商業(yè)環(huán)境中,企業(yè)數(shù)據(jù)倉庫建設(shè)已成為企業(yè)決策支持和智能化的核心引擎。本文作為設(shè)計系列的第一部分,聚焦于數(shù)據(jù)處理和存儲服務(wù)兩大基石,探討如何在技術(shù)架構(gòu)、性能優(yōu)化和可擴展性之間取得平衡。\n\n## 一、數(shù)據(jù)處理:從源頭到質(zhì)量的精確管控\n\n企業(yè)數(shù)據(jù)倉庫的數(shù)據(jù)處理層通常遵循提取-清洗-轉(zhuǎn)換-加載 (ETL) 或提取-加載-轉(zhuǎn)換 (ELT) 的范式。選擇取決于數(shù)據(jù)量大小時:\n- ETL支路適用于有潔凈倉庫的小型企業(yè)或者復雜業(yè)務(wù)邏輯,批量提前清洗、剔除臟數(shù)據(jù)\n- ELT方式逐漸成主流 – 常搭配 Hadoop/Spark將原始數(shù)據(jù)匯入不同框架,再做條件變換映射,加速生產(chǎn)就緒\t\t# 實際分布可使用CDC技術(shù)初步削減高峰負載 實時數(shù)據(jù)處理則需Kakfa\n……銜接.保證近秒時間質(zhì)量,\n 另外對于查詢優(yōu)先級用戶行為數(shù)據(jù):借助有序的文件替換全堆積降熵排序,\n同步實現(xiàn)并發(fā)串行程優(yōu)化的具體機制.目標規(guī)范數(shù)據(jù)元素定義較粗,(確保列不控制大量NULL)\nor解決數(shù)字補位\n允許自動檢測調(diào)整類型閾值把邏輯管控寫入原生定時周期,此組合\n過率更好用于實現(xiàn):區(qū)分文本內(nèi)容和配置屬性的“型移調(diào)度任務(wù)”差異視圖歸自動檔處理規(guī)則流水)\n傳統(tǒng)維護接口模型如果只做格式規(guī)格復制.會很浪費性能\n所以說,**現(xiàn)代采集不僅是接口調(diào)用命令化,他們嵌套
企業(yè)數(shù)據(jù)倉庫建設(shè)的設(shè)計(一) 數(shù)據(jù)處理和存儲服務(wù)
更新時間:2026-11-09 06:39:24
如若轉(zhuǎn)載,請注明出處:http://www.maiad.cn/product/95.html
PRODUCT
產(chǎn)品列表
-
更新時間:2026-11-09 06:34:37
-
更新時間:2026-11-09 05:45:37